유료 모델 Claude Opus 5.5에게 2026학년도 수능 수학과 2025년 세무사 1차 재정학을 이미지로 풀게 했더니 둘 다 만점이었다. 예상한 결과다.
궁금한 건 일반 게이밍 PC(RTX 5070 Ti 16GB)와 맥북(M1 Max)에 직접 설치한 로컬 LLM이 어디까지 푸느냐였다. 그래서 같은 이미지와 프롬프트로 Gemma 4 12B를 돌렸다.
PDF 텍스트 추출 대신 이미지 입력을 썼고, 로컬 모델에는 생성 상한 32K와 답 재요청을 적용했다. 최종 수학 점수는 84점이었다. 어려운 문항에서는 상한에 걸린 뒤에도 오답이나 무응답이 남았다.
요약
- 입력: 평가원 PDF → 이미지 렌더링 → 2단 시험지를 단별로 잘라 Ollama 비전 API에 전달
- 순정 조건: RAG·추가 학습·파인튜닝·웹 검색 없음. 이미지 한 장과 고정 프롬프트만
- 수학 실행 조건: 문맥 48K, 생성 상한 32K. 상한에 걸리고 정답 줄이 없으면 부분 풀이를 넘겨 생각 모드를 끈 새 요청으로 답만 요구
- Gemma 4 12B(Q4_0 QAT): 84점(26/30), 오답 2개·무응답 2개. 최종 응답의 소요 시간 합계 51.6분(기존 응답 재사용 포함)
- 참고: M1 Max 32GB에서는 최종 77점, 152.1분. 수학 시험시간 100분을 넘긴 결과여서 주요 성적 비교에서는 제외
- Claude Opus 5.5(effort medium): 수능 100점, 재정학 100점(40/40). 세법학개론은 일부(23문항)만 풀었는데 19문항 정답
- 한계: 두 시험 모두 모델 공개 전에 나온 문제라 데이터 오염 가능성이 있다. 2026-11-19 수능 당일 재테스트 예정
- 시간 평가: 수학 영역 100분을 기준으로 비교하되, 이번 합산 시간을 100분 제한 연속 실행 결과로 해석하지 않음
1. 환경
항목 값
| CPU / RAM | Ryzen 7 9800X3D / DDR5 32GB |
| GPU | RTX 5070 Ti 16GB (메모리 대역폭 896GB/s) |
| 런타임 | Windows 11 + WSL2 Ubuntu 24.04 + Ollama 0.40.11 (127.0.0.1만 열림, flash attention, KV 캐시 q8_0) |
| 로컬 모델 | gemma4:12b-it-qat: 11.9B dense, Q4_0(QAT), 7.2GB, 이미지 입력·thinking 지원 |
| 클라우드 모델 | Claude Opus 5.5, effort medium, claude -p 헤드리스 + Read 도구로 이미지 열기 |
| 참고 실행 노트북 | MacBook Pro M1 Max 32GB, gemma4:12b-mlx, MLX nvfp4(파일 7.7GB), 이미지·thinking 지원 |
ollama show로 확인한 모델 정보다.
architecture        gemma4
parameters          11.9B
context length      262144
quantization        Q4_0
Capabilities        completion, vision, audio, tools, thinking
2. PDF 텍스트 추출이 통하지 않았다
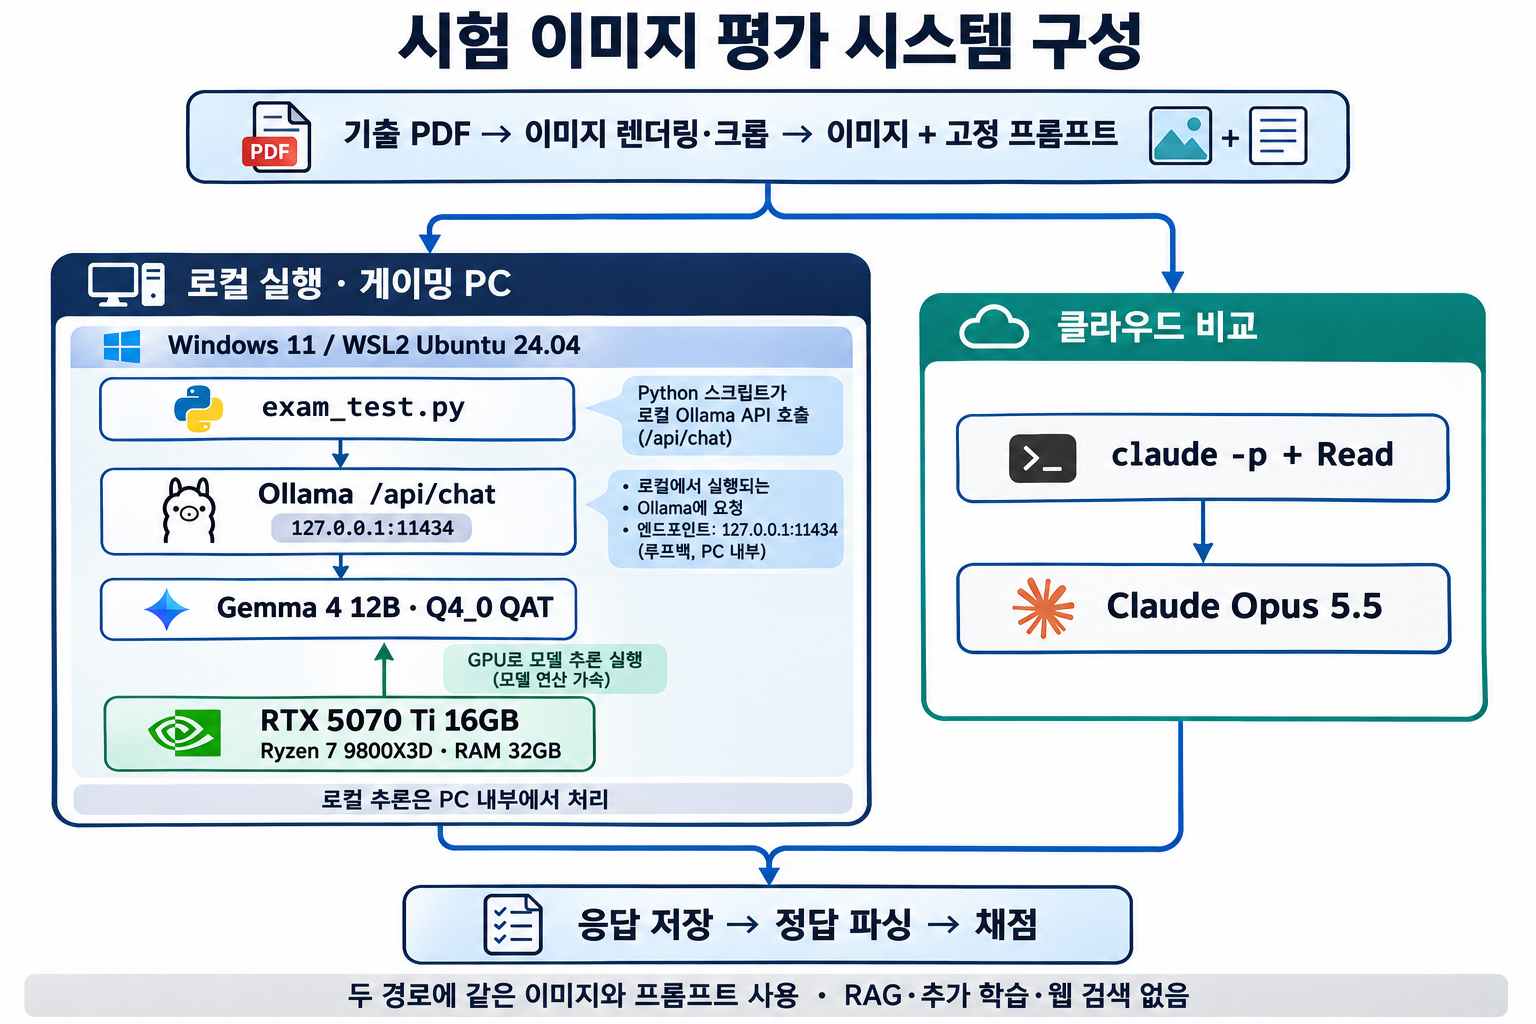
로컬 경로는 WSL2의 스크립트가 루프백 주소의 Ollama API를 호출한다. 클라우드 비교 경로는 같은 입력을 Claude에 별도로 전달한다.
처음 계획은 PDF에서 텍스트를 뽑아 넣는 것이었다. pypdf로 수능 수학 PDF를 열자 문항 번호와 한글은 나오는데 수식이 전부 사라졌다.
1.
×
   의 값은? [2점]
①  ②  ③  ④  ⑤
수식이 사설 영역 글리프로 들어가 있어 텍스트로 복원할 수 없었다. 세무사 PDF는 아예 스캔본이라 텍스트 레이어가 없었다.
그래서 이미지로 바꿨다. 수능 시험지는 2단 편집이라 쪽 전체를 넣으면 축소되면서 첨자와 분수가 뭉개진다. 쪽을 2.5배로 렌더링하고 왼쪽·오른쪽 단을 따로 잘랐다. 첫 쪽만 머리글이 커서 위 여백을 다르게 줬다.
import pypdfium2 as pdfium

pdf = pdfium.PdfDocument("math_q.pdf")
for i in pages:  # 홀수형 공통 1~8쪽 + 미적분 13~16쪽
    im = pdf[i].render(scale=2.5).to_pil()
    w, h = im.size
    top = int(h * (0.185 if i == 0 else 0.125))  # 첫 쪽만 큰 머리글
    bot, mid = int(h * 0.89), w // 2
    im.crop((int(w * 0.09), top, mid - 8, bot)).save(f"p{i:02d}_L.png")
    im.crop((mid + 8, top, int(w * 0.91), bot)).save(f"p{i:02d}_R.png")
수능 수학은 24장, 세무사 재정학은 쪽 단위 12장이 나왔다. PyMuPDF는 AGPL이라 쓰지 않고 pypdfium2(Apache/BSD)를 썼다.
3. Ollama 비전 API 호출
이미지는 base64로 images에 넣는다. 생각 모드는 think: true. 답은 마지막 줄 정답: 번호=답 형식으로 받아 정규식으로 채점했다.
body = {
    "model": "gemma4:12b-it-qat", "stream": False, "think": True,
    "messages": [{"role": "user", "content": PROMPT,
                  "images": [base64.b64encode(img.read_bytes()).decode()]}],
    "options": {"num_ctx": 49152, "num_predict": 32768, "temperature": 0.3, "seed": 42},
}
r = json.load(urllib.request.urlopen(urllib.request.Request(
    "http://127.0.0.1:11434/api/chat", json.dumps(body).encode(),
    {"Content-Type": "application/json"}), timeout=3600))
answer, thinking = r["message"]["content"], r["message"].get("thinking", "")
num_ctx는 입력과 생성 내용을 담는 문맥 크기이고, num_predict는 생각과 답을 포함한 생성 상한이다. 이미지·프롬프트와 긴 풀이가 함께 들어가도록 문맥 48K, 생성 상한 32K를 사용했다. 상한은 이미지 한 장에 대한 요청마다 적용되며, 문항마다 별도로 32K를 배정한 것은 아니다.
초기 시행착오에서는 생성 상한 16K를 썼다. 최종 집계에서는 그때 완료된 이미지의 응답을 재사용하고, 상한에 걸린 이미지만 32K로 다시 실행했다(--reuse). 따라서 아래 결과는 전 이미지를 처음부터 32K로 다시 돌린 단일 실행과 구분해야 한다.
4. 결과
모델·조건 수능 수학 정답 / 오답 / 무응답 기록된 풀이 시간
| Opus 5.5 (medium) | 100점 | 30 / 0 / 0 | 4.2분 |
| Gemma 4 12B (생성 상한 32K + 답 재요청) | 84점 | 26 / 2 / 2 | 51.6분* |
※ Gemma의 51.6분은 최종 채점에 사용한 응답별 wall_s를 합한 값이다. 재사용한 응답과 재실행·답 재요청한 응답이 섞여 있다. 기록된 생성 속도는 76.2 tok/s였다.
Gemma의 오답은 10·30번, 무응답은 21·22번이었다. 상한 안에서 끝난 14·20번은 정답이었다.
수학 영역 시험시간은 100분이다. 이번 합산 시간은 100분보다 짧지만, 실제로 100분 제한을 적용해 처음부터 연속 실행한 결과는 아니다. 입력 처리와 답 재요청을 포함한 전체 실행시간, 제한시간까지 확보한 답을 함께 봐야 하드웨어·모델 비교가 된다.
참고: M1 Max 32GB 실행
맥은 같은 이미지 24장을 생성 상한 32K, 문맥 48K, 답 재요청 조건으로 처음부터 연속 실행했다.
항목 M1 Max 32GB
| 모델·양자화 | gemma4:12b-mlx · MLX nvfp4 |
| 최종 점수 | 77점 · 정답 24 / 오답 1 / 무응답 5 |
| 전체 실행시간 | 152.1분 (23:01~01:33) |
| 수학 시험시간 100분과 비교 | 52.1분 초과 · 100분 시점 점수는 미집계 |
| 평균 생성 속도 | 46.0 tok/s |
| 생성 토큰 합계 | 348,401 |
| 생성 상한 도달 이미지 | 9 / 24장 |
77점은 제한시간 이후의 답까지 포함한 최종 점수다. 100분을 한참 넘겼으므로 주요 성적 비교에는 넣지 않고 참고로만 기록한다. 데스크톱의 51.6분은 응답 재사용을 포함한 합산 시간, 맥의 152.1분은 전체 연속 실행 시간이다. 모델 양자화·런타임도 달라 이 차이를 하드웨어만의 효과로 해석할 수 없다.
맥의 오답은 10번, 무응답은 21·27·28·29·30번이었다. 데스크톱이 못 맞힌 22번은 맥에서 맞혔지만, 데스크톱이 맞힌 27·28·29번은 맥에서 무응답이었다. 같은 모델 계열과 생성 상한이라도 문항별 결과는 달랐다.
별도 실험인 2025년 제62회 세무사 1차 재정학은 초기 설정에서 27.5점(정답 11·오답 5·무응답 24), 33.3분이었다. Claude는 40/40, 2.6분이었다. 재정학은 32K로 재실행하지 않아 위 수학 결과와 같은 조건의 비교로 묶지 않았다. 쪽 단위 이미지 한 장에 3~4문항이 들어가 요청당 풀어야 할 양도 달랐다.
5. 상한 도달 후 답 재요청
생성 상한에 걸리고 정답 줄이 없을 때는 부분 풀이를 assistant 메시지로 전달하고, think: false인 새 요청으로 답만 요구했다. s1 논문의 budget forcing에서 상한 도달 후 답을 내게 한다는 발상과 닿아 있지만, 이 구현은 같은 생성에 생각 종료 토큰을 삽입하는 방식이 아니다.
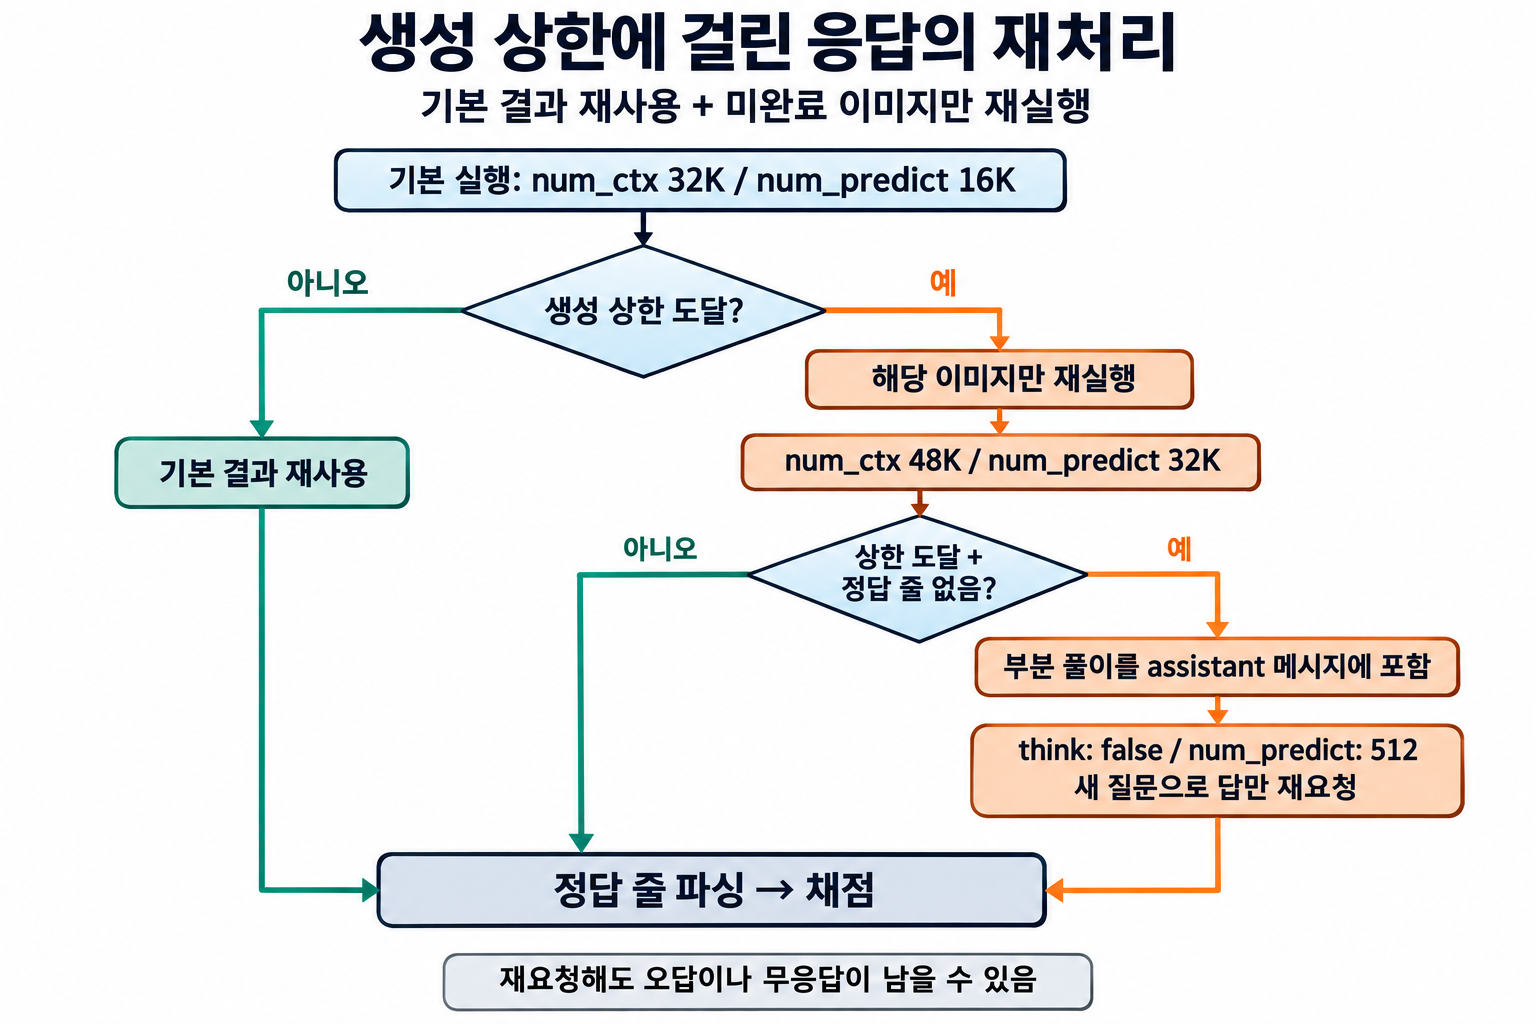
데스크톱에서 초기 완료 응답을 재사용하고 미완료 이미지만 다시 푼 흐름이다. 오른쪽 아래가 32K 상한 이후 답 재요청 절차에 해당한다.
if force and out["gen_tok"] >= max_tokens and "정답" not in out["answer"]:
    partial = out["thinking"] + "\n" + out["answer"]
    f = ollama_chat(host, {"model": model, "stream": False, "think": False,
        "messages": [user, {"role": "assistant", "content": partial},
                     {"role": "user", "content": FORCE}],   # "생각할 시간이 끝났다. 답만 적어라"
        "options": {**body["options"], "num_predict": 512}})
첫 요청의 상한은 32,768토큰이고 답 재요청은 최대 512토큰이다. 스크립트는 두 요청의 생성 토큰을 합산하므로, 상한에 걸린 이미지의 로그에는 최대 33,280토큰(약 33.3K)이 찍힐 수 있다. 문맥 크기가 33.3K라는 뜻은 아니다.
문항 32K + 답 재요청 결과 생성 토큰(재요청 포함)
| 10번 | 32K에도 미완 → 강제 답 ④, 오답 (정답 ③) | 3.3만 |
| 14번 | 상한 안에서 완료, 정답 | 1.4만 |
| 20번 | 상한 안에서 완료, 정답 | 1.7만 |
| 21·22번 | 32K에도 미완, 강제 답변도 '정답:' 줄 없이 계산을 이어 써서 무응답 | 3.3만 |
| 30번 | 32K에도 미완 → 강제 답 0, 오답 (정답 11) | 3.3만 |
14·20번은 풀이를 마쳐 정답을 냈지만, 10·30번은 답만 재요청해도 오답이었다. 21·22번은 재요청에서도 정답: 줄 없이 계산을 이어 썼다. 예산 부족뿐 아니라 입력 인식, 풀이의 수렴 여부, 출력 형식 준수도 살펴야 했다.
그래서 생성 상한을 계속 늘리는 것만으로 개선을 판단하지 않으려 한다. Qwen도 같은 이미지와 32K 조건으로 비교하고, 최종 판단은 수학 시험시간 100분 안에 확보한 점수와 무응답 수로 할 계획이다.
6. 자원 사용
데스크톱의 이번 수학 실행에는 연속 자원 모니터링 기록이 없다. 실행 중 확인한 작업 관리자에서는 GPU 사용률 89%, 전용 GPU 메모리 9.5/16GB로 표시됐다. 한 시점의 관찰값이므로 평균·최대로 쓰지는 않는다.
참고 실행한 맥은 5초 간격 1,704개 샘플에서 GPU 사용률 평균 94.4%, 최대 100%, GPU가 쓰는 통합 메모리 평균 9.3GB, 최대 13.1GB였다. 시스템 전체 메모리 사용량은 평균 29.1GB, 최대 31.0GB였다. 통합 메모리이므로 GPU 사용량과 시스템 전체 사용량을 더하면 안 되며, 후자는 모델만의 점유량도 아니다.
별도 powermetrics 기록에서 GPU 평균 전력은 40.3W, CPU·GPU·ANE 합산 평균은 40.9W였다. 이 합산 전력과 실행시간으로 추산한 에너지는 약 104Wh로, 노트북 전체의 콘센트 소비전력을 측정한 값은 아니다. 맥은 전원 연결·유튜브 미재생 상태였고, 발열과 평소보다 큰 팬 소리가 있었지만 거슬릴 정도는 아니었다.
데스크톱에서는 유튜브를 재생하면서 돌렸고 끊김은 없었다. 두 기기는 동시 사용 조건도 달라 자원 사용량을 직접 맞비교하지 않는다.
7. 한계
데이터 오염. 2026학년도 수능(2025-11-13 시행)과 2025 세무사 1차(2025-04-26)는 두 모델이 공개되기 전에 나온 시험이다. 학습 데이터에 문제와 정답이 포함됐을 가능성은 있으나, 실제 포함 여부는 확인하지 못했다. Opus의 만점이 풀이인지 기억인지 이 실험만으로 가를 수는 없다.
다만 세무사에서는 추가로 세법학개론을 중간까지 풀린 결과가 있다. 저장된 문항별 기록 기준으로 41~63번, 23문항 중 19문항 정답·4문항 오답이었다. 54~57번에서 오답이 나왔으므로, 재정학 만점만 보고 세무사 기출 정답을 그대로 기억해 재현했다고 해석하기는 어려웠다. 내 판단으로는 세무사 결과에서 데이터 오염 가능성을 높게 볼 근거가 충분하지 않았다. 다만 이는 부분 실행에서 얻은 관찰이며, 오답이 나온다는 사실이 학습 데이터 포함 가능성을 배제하거나 오염 확률을 정량적으로 낮춰 주는 검증은 아니다.
이미지 입력. 2026학년도 수능 수학으로 24개 모델을 평가한 arXiv 2511.18649는 문제 공개 2시간 안에 디지털화해 오염을 막았고, 모든 모델에서 이미지 입력이 텍스트 입력보다 낮았다고 보고했다. 같은 논문에서 gpt-oss-20B는 텍스트 입력으로 95.7점이었다. 이미지로 넣은 이번 실험은 불리한 쪽 조건이다.
기출·해설로 문맥을 보강할 여지. 같은 시험 범위의 기출·모의고사와 검증된 해설을 제공하면, 모델은 유사 유형의 풀이 접근법과 중간 계산, 공식 적용 사례를 참고할 수 있다. 필요한 예제를 문맥에 직접 넣는 방식과, 기출 자료집에서 관련 문제·해설을 검색해 넣는 RAG 모두 가능하다. 모델을 추가 학습시키지 않고도 풀이에 쓸 정보를 보강하는 방식이다.
이런 구성은 Opus와 로컬 모델 양쪽에서 정답률 개선을 기대할 만한 방향이다. 수학 지식 검색을 평가한 연구에서도 관련성이 높은 수학 지식을 제공했을 때 성능 개선을 관찰했다. 이번 실험은 이런 사전 준비 없이 문제 이미지와 고정 프롬프트만 준 조건이므로, 기출·해설을 활용한 시스템의 성능 상한을 측정한 것은 아니다.
실제 개선 폭은 새 문제에서 확인해야 한다. 이번 Opus는 이미 만점이므로 더 어려운 문제나 새로운 시험에서 비교하고, 평가할 문제 자체의 정답·해설은 참고 자료에서 제외한다. 수학 영역 100분 기준으로는 검색·입력 처리 시간을 포함해 최종 확보한 점수를 비교할 계획이다.
그래서 2026-11-19 2027학년도 수능 당일, 문제지가 공개되면 같은 스크립트로 바로 다시 풀고 정답 공개 전에 답을 커밋해 둘 생각이다. 로컬 모델은 그 전에 같은 PC에서 실행 가능한 Qwen3.6-35B-A3B와 비교한다. 벤치마크 점수만으로 교체하지 않고, 같은 입력·생성 상한에서의 점수와 전체 실행시간을 함께 확인하려고 한다.
정리
- 유료 클라우드 모델(Opus 5.5)은 수능 수학·세무사 재정학 모두 만점이었다
- 게이밍 PC의 Gemma 4 12B는 생성 상한 32K + 답 재요청 조건을 적용한 최종 집계에서 수능 수학 84점(정답 26·오답 2·무응답 2)이었다
- 51.6분은 응답 재사용을 포함한 합산 시간이다. 참고 실행한 맥북은 77점·152.1분으로 시험시간을 넘겼다. 100분 내 성적으로 해석하지 않는다
- 어려운 문항에서는 생성 예산뿐 아니라 입력 인식과 출력 형식도 결과에 영향을 줬다
8. 보안 관점
로컬 LLM은 클라우드 API와 달리 제공사 로그와 인터넷 트래픽이 남지 않는다. 스마트 안경 같은 기기와 묶으면 남는 기술적 단서는 근거리 무선 신호 정도라, 시험장 대응이 전파 탐지 쪽으로 가는 이유가 된다. 구체적인 연결 방법은 다루지 않는다.
9. 재현
스크립트는 exam_test.py 하나로 묶었다: fetch(문제지 받기) → prep(이미지) → solve(Ollama/Claude) → grade → monitor(5초 간격 GPU·CPU·메모리, 윈도우는 nvidia-smi, 맥은 ioreg).
python exam_test.py fetch && python exam_test.py prep
python exam_test.py solve --set math --model gemma4:12b-it-qat --think --max-tokens 32768 --force-answer --tag desk_gemma_32k_full
python exam_test.py grade --set math --tag desk_gemma_32k_full
위 명령은 새 태그로 전 이미지를 32K 조건에서 실행한다. 기존 최종 집계와 달리 이전 응답을 재사용하지 않는다. --max-tokens는 요청당 생성 상한이며, 현재 스크립트에는 전체 100분을 자동으로 종료하는 옵션이 없다. 100분 기준 평가에서는 시작·종료 시각과 제한시간 안에 저장된 답을 따로 기록해야 한다.
결과 수치와 PC 사용 체감, 맥북 비교, 스마트 안경 이야기를 더 가볍게 정리한 글은 네이버 블로그에 올렸다.
https://blog.naver.com/subcoding/224476387024
로컬 AI로 풀어본 수능 수학. 게이밍 PC는 84점 (Claude는 당연히 100점)
결론부터. 유료 클라우드 AI인 Claude Opus 5.5는 작년 수능 수학 만점이었다. 예상대로였다. 궁금했던...
blog.naver.com
'AI' 카테고리의 다른 글
| [보안] PHP2Shell 새벽 대응기: 공식 이미지 없이 PHP 8.3.36 워드프레스 빌드 (with claude) (0) | 2026.10.22 |
|---|---|
| [AI 자동화] Claude·Gemini 구독으로 트렌드 리포트 파이프라인 만들기 (0) | 2026.10.19 |

