매일 아침 관심 주제별 트렌드 리포트가 GitHub에 쌓이게 만들었다.
이미 구독 중인 Claude와 Gemini CLI를 사용했고, 숫자는 구글 트렌드와 네이버 API에서 직접 받아 AI의 답을 검증한다.
집 NAS의 Docker 컨테이너가 매일 07:30에 돌린다.
이 글은 구현 쪽 이야기다.
코딩 없이 따라 하는 사용법과 실제 리포트 예시는 simplelife에 글이 있다.
https://simplelife.ai.kr/ai-trend-report/
AI 트렌드 리포트 자동화, 관심사만 정하면 매일 아침 받아 보는 법 - simplelife
관심사와 원하는 결과를 적어 두면 AI 둘이 조사하고, 네이버·구글 실측 숫자로 확인한 리포트가 매일 아침 GitHub에 쌓입니다. 데이터 흐름과 키워드 고르는 법을 패션 리포트 예시로 정리했습니
simplelife.ai.kr
요약
- LLM 호출은 전부 구독 CLI다: Claude는
claude -p(Claude Code 헤드리스), Gemini는agy -p(Antigravity CLI) - 같은 요청서를 두 모델이 동시에 조사하고, 세 번째 호출이 둘을 합친다
- AI가 낸 후보 키워드를 네이버 API로 다시 조회해서 순위를 숫자로 정한다
- 작업별 모델은 JSON 한 곳에서 관리한다 (조사는 Haiku·Gemini, 통합은 Sonnet)
- 실행은 포트를 하나도 열지 않은 NAS Docker 컨테이너, 결과물만
git push
1. 왜 이렇게 만들었나
처음에는 "요즘 뭐가 뜨는지 알려줘"를 AI에게 매일 물었다. 답은 그럴듯했지만 문제가 두 가지 있었다.
- 숫자가 없다. "급상승"이라고 써 놓고 근거가 없거나, 실제로는 검색량이 줄고 있는 키워드가 섞였다.
- 모델마다 놓치는 게 다르다. Gemini는 구글·유튜브 검색이 강하고, Claude는 공식 문서와 날짜·금액 확인이 꼼꼼했다.
그래서 순서를 바꿨다. 숫자는 스크립트가 먼저 모은다. AI 둘은 그 숫자를 출발점으로 따로 조사한다. 마지막 순위는 다시 숫자로 정한다. 출발점은 조코딩 x 엔조이커플 "맥미니 AI 직원" 영상의 트렌드 자동화 프롬프트였고, 이를 내 환경(구독 CLI, 네이버 데이터, NAS)에 맞게 다시 짰다.
2. 전체 구조
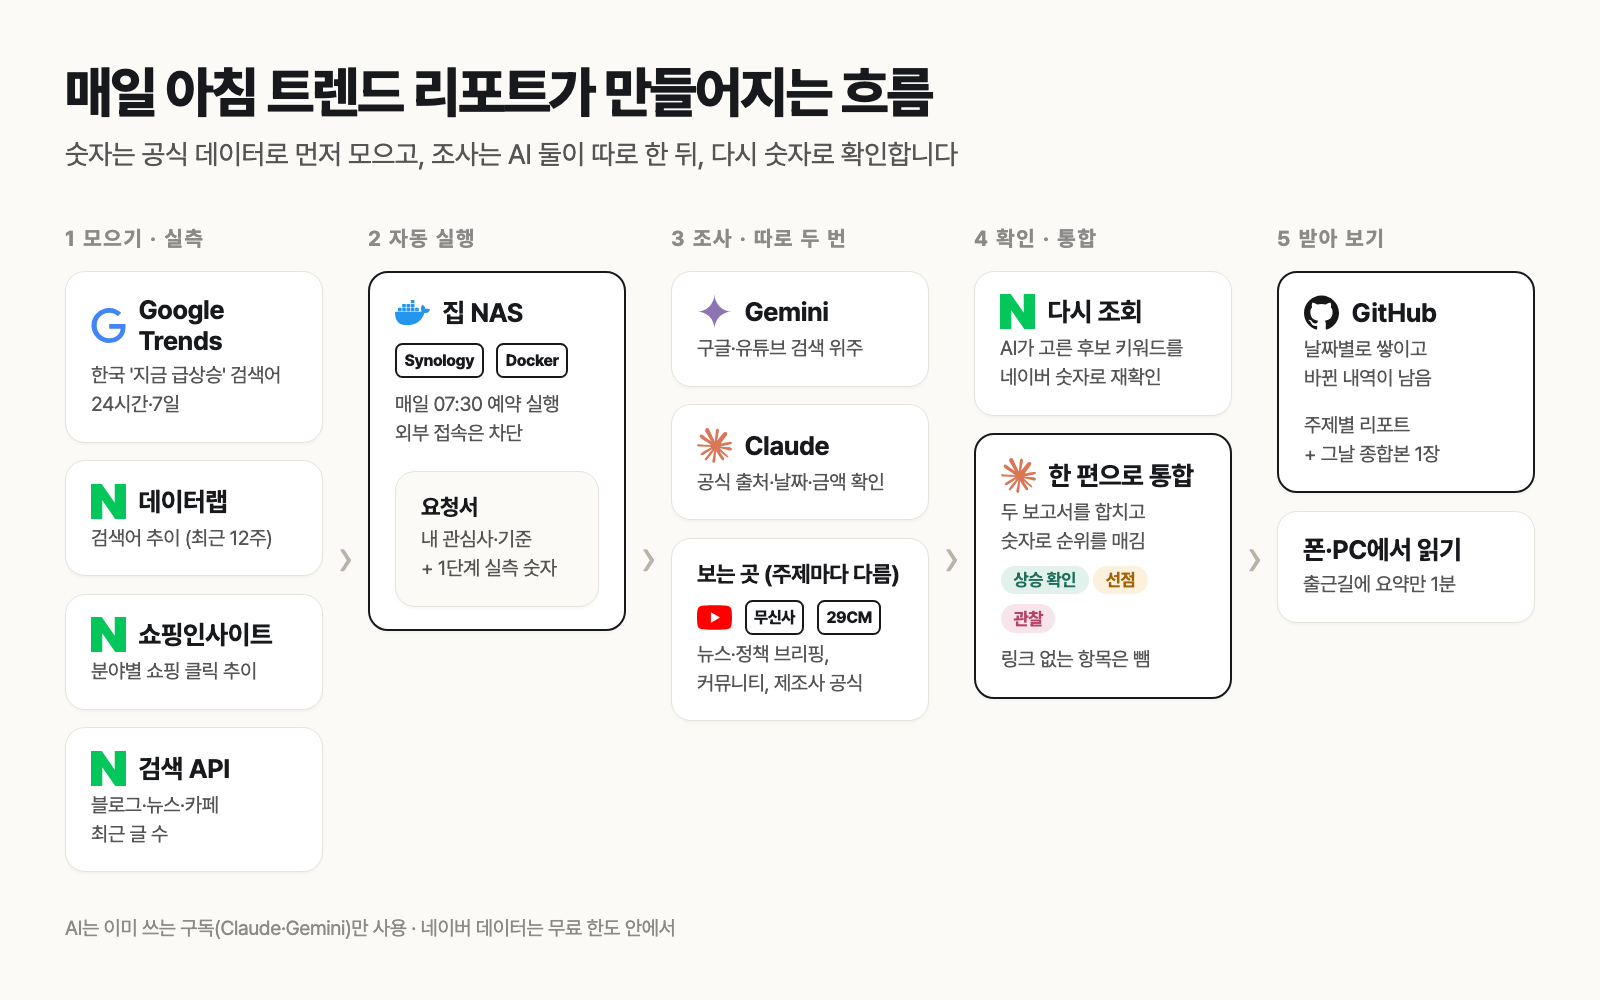
trend_profiles.json (주제별 관심사·출처·관찰 키워드)
        │
        ▼
build_request()  ── Google Trends 급상승(RSS·페이지) + 네이버 API 5종 실측
        │                → gemini/requests/YYMMDD_trend_<주제>.md
        ▼
┌──────────────┬──────────────┐   ThreadPoolExecutor(max_workers=2)
│ agy -p       │ claude -p     │
│ (Gemini)     │ (Haiku+웹검색) │
└──────┬───────┴──────┬───────┘
       ▼              ▼
   reports/<이름>.md  reports/<이름>_claude.md
        │
        ▼
verify_candidates() ── 두 보고서의 '추이 확인 키워드'를 네이버 API로 재조회
        │
        ▼
merge_reports()  ── claude -p (Sonnet): 통합·순위·링크 없는 항목 제거
        │
        ▼
trends/<주제>/YYMMDD_trend_<주제>.md + SVG 차트 → 날짜별 종합본 → git push
주제는 프로필 JSON 하나에 들어 있다. 지금은 AI, 뉴스, 카메라·사진, 영상 편집 등 7개를 매일, 패션을 매주 월요일에 돌린다. 프로필에는 독자, 분야, 볼 사이트, 판단 기준, 원하는 결과 형식, 관찰 키워드를 적는다. 코드 수정 없이 JSON에 한 덩어리 추가하면 다음 날부터 같이 돈다.
3. 구독 CLI를 함수처럼 부르기
API SDK 대신 CLI를 subprocess로 부른다. 핵심은 두 줄이다.
# Claude: Claude Code 헤드리스 모드
cmd = ["claude", "-p", "--model", model, "--output-format", "text",
       "--tools", "WebSearch,WebFetch" if web else ""]

# Gemini: Antigravity CLI. 작업 폴더의 AGENTS.md(쓰기 범위·출처 규칙)를 읽게 한다
cmd = ["agy", "-p", prompt, "--model", model, "--print-timeout", f"{timeout}s"]
이걸 감싼 router.py가 작업 이름을 받아 엔진과 모델을 고른다. 스크립트는 모델 이름을 모른다.
text = router.chat("script/trend_merge", prompt)      # → sonnet
text = router.chat("script/trend_report_claude", prompt, web=True)  # → haiku + 웹 검색
{
"tiers": {
"haiku": {"engine": "claude", "model": "haiku"},
"sonnet": {"engine": "claude", "model": "sonnet"},
"gemini": {"engine": "agy", "model": "gemini-4-argon-high", "fallback_tier": "sonnet"}
},
"tasks": {
"script/trend_report": {"tier": "gemini"},
"script/trend_report_claude": {"tier": "haiku"},
"script/trend_merge": {"tier": "sonnet"}
}
}모델 배정을 바꿀 때는 이 JSON만 고친다. 매일 7~8개 주제에 도는 Claude 조사는 처음에 Sonnet이었다. 구독 사용량이 가장 많이 나가는 곳이라 Haiku로 내렸다. 주 조사는 Gemini가 하고 Claude는 공식 출처 보강만 맡기 때문이다. router.chat()으로 부르는 작업은 agy가 실패하면(시간 초과·빈 답) fallback_tier의 Claude로 넘어가고, agy가 모델 이름을 모르면 한 단계 낮은 Gemini 모델로 다시 시도한다. 트렌드 조사의 Gemini 쪽은 실패하면 재시도 없이 Claude 보고서만으로 진행한다.
운영하면서 생긴 처리도 몇 가지 있다.
- 잠자기 방지: 맥에서 돌릴 때 잠자기에 들어가면 CLI가 멈췄다. 실행 중에는
caffeinate로 막고,agy는--print-timeout+ 60초를 넘기면 프로세스를 끊는다. - 한쪽 실패 허용: 두 보고서 중 하나만 나오면 그것만으로 진행하고 로그에 남긴다. 둘 다 없을 때만 실패로 처리한다.
- 재사용: 같은 날 통합만 다시 하고 싶으면
--reuse로 원본 보고서를 그대로 쓴다.
4. 숫자로 검증하기: 네이버 API 두 번 쓰기
AI는 Google Trends 비교 화면이나 데이터랩 차트를 직접 조작하지 못한다. 그래서 숫자는 스크립트가 공식 API로 받는다. 네이버 API는 두 번 쓴다.
① 요청서 만들 때 (참고 데이터)
프로필의 관찰 키워드로 검색어 트렌드(최근 12주), 쇼핑인사이트 클릭 추이(프로필에 쇼핑 분야를 지정했을 때), 블로그·뉴스·카페 전체 문서 수와 최근 글을 받아 요청서에 표로 넣는다. AI에게는 "데이터에서 관련 신호부터 고르고, 상승 근거는 수치로 써라"고 지시한다.
② 보고서가 나온 뒤 (재검증)
두 모델은 보고서 끝에 '추이 확인 키워드'를 5개 이내로 정해진 형식으로 적는다. 스크립트가 이걸 파싱해서 네이버로 다시 조회하고, 결과 표를 통합 단계에 넘긴다. 통합 모델은 이 표로 순위를 매긴다.
| 판정 | 기준 |
|---|---|
| 상승 확인 | 검색량 +20% 이상, 또는 지난주가 직전 4주 평균의 1.3배 이상, 또는 구글 급상승 포함(주제와 관련 있을 때만), 또는 최근 7일 뉴스 20건 이상 |
| 선점 | 지금은 보합·하락이지만 시즌상 곧 오를 것 (연말정산 등) |
| 관찰 | 데이터 근거 없음. 블로그 글 수만 많은 경우도 여기 (흔한 키워드는 늘 많다) |
예를 들어 패션 리포트에서 AI는 '처카부츠'를 올렸지만, 재조회해 보니 검색어가 신규라 지난주 비율이 0.0배였다. 그래서 '처카부츠'는 '관찰'로 내려가고, 쇼핑 클릭 +178%가 확인된 '니트'가 위로 올라갔다.
네이버 API는 NCP NAVER API HUB로 이관된 뒤에도 무료 한도가 있다. 호출 수를 naver_usage.json에 세고 무료 한도의 90%에서 멈추게 했다. 프로필 한 번에 많아야 40회 남짓이라, 7개 주제를 매일 돌려도 무료 한도까지는 여유가 많다.
통합 프롬프트에는 이런 규칙을 넣었다.
- 두 보고서에 있는 사실만 쓴다. 새 링크를 만들지 않는다.
- 상세 링크가 없는 영상·상품은 빼고 '확인 못 한 것'에 남긴다.
- 표 끝에 '찾은 쪽'(Gemini/Claude/둘 다)과 '데이터'(판정 + 핵심 수치) 열을 붙인다.
일주일 동안 직접 확인한 범위에서는 틀린 내용을 아직 못 봤다. 교차 확인에서 걸린 항목은 대부분 "확인 못 한 것"으로 빠졌다.
5. 실행 환경: 포트 없는 NAS Docker 샌드박스
처음엔 맥 launchd로 예약했는데, 맥이 잠들면 예약이 밀렸다. 24시간 켜진 시놀로지 NAS로 옮겼다. 에이전트에게 쉘을 주는 구조라서 격리를 우선했다.
services:
  agent:
    image: agent-sandbox:latest
    network_mode: bridge        # ports 없음 = 밖에서 들어올 수 없음
    cap_drop: [ALL]
    security_opt: [no-new-privileges:true]
    pids_limit: 512
    cpu_shares: 512             # DSM 커널은 CPU 쿼터 미지원이라 우선순위만 낮춤
    mem_limit: 6g
    env_file: ./agent.env       # 장기 토큰 등 비밀값 (저장소에 안 올림)
    volumes:
      - ./workspace:/work/workspace   # 작업 저장소 사본
      - ./home/claude:/home/agent/.claude
      - ./home/gemini:/home/agent/.gemini
      - ./home/keyrings:/home/agent/.local/share/keyrings   # agy 로그인 유지
들어오는 연결은 막고, 나가는 연결만
- 들어오는 연결 없음: 포트를 열지 않는다. 관리는 NAS에 SSH로 들어가
docker exec. - 나가는 연결만: CLI 로그인 서버, 네이버 API, GitHub. WebFetch가 임의 사이트를 읽어야 해서 목적지는 막지 않았다.
로그인 유지와 예약
- 로그인 유지: Claude는 장기 토큰을 환경 변수로, Gemini는 컨테이너 안 키링에 저장하고 볼륨으로 유지한다. 컨테이너를 새로 만들어도 다시 로그인하지 않는다.
- 동시 실행: 프로필은 3개씩 동시에 돈다(
--parallel 3, NAS CPU 4코어 기준). 프로필 하나 안에서는 위의 두 모델이 다시 동시에 돈다. - 예약: DSM 작업 스케줄러가 매일 07:30에
docker exec agent-sandbox .../run_trend.sh를 부른다.
run_trend.sh는 git pull → 프로필 목록 결정 → 리포트 생성 → 결과물 경로만 git add → commit → push 순서다. 작업 저장소의 다른 변경은 건드리지 않는다. 프로필 목록을 환경 변수에 하드코딩했다가 새 프로필이 빠진 적이 있어서, 지금은 비워 두고 매번 JSON에서 읽는다.
6. 주의할 점: 구독 약관
주의할 점이 있다. Anthropic 소비자 약관에는 API 키를 쓰거나 명시적으로 허용한 경우가 아니면 봇·스크립트 같은 자동화 접근을 금지하는 조항이 있다(Consumer Terms). Google 개인 계정 쪽도 비슷한 취지의 조항이 있는 것으로 안다. claude -p는 공식 기능이지만, 무인 예약 실행까지 허용 범위인지는 약관에 따로 적혀 있지 않다.
개인용으로 하루 한 번, 사람이 직접 돌리는 것과 같은 양만 쓴다. 그래도 위험이 없다고는 할 수 없다. 규모를 키울 생각이면 Claude는 API 키, Gemini는 AI Studio API 키로 바꿔야 한다. 가장 쉬운 방법은 CLI는 그대로 두고 인증만 API 키로 바꾸는 것이다(claude는 ANTHROPIC_API_KEY, agy는 GEMINI_API_KEY). SDK로 완전히 옮기려면 router.py의 호출 함수 몇 개와 보고서 파일 쓰기·웹 검색 부분을 손봐야 한다.
7. 정리
| 고민 | 선택 |
|---|---|
| AI가 숫자를 지어낸다 | 숫자는 스크립트가 공식 API로 받고, 후보도 네이버 API로 다시 조회해 순위를 정한다 |
| 모델마다 놓치는 게 다르다 | 두 모델이 동시에 조사하고 세 번째 호출로 합친다 |
| 사용량이 많이 나간다 | 작업별 tier를 JSON 한 곳에서 관리하고, 반복 조사는 Haiku로 돌린다 |
| 맥이 잠들면 멈춘다 | 포트 없는 NAS Docker 컨테이너를 DSM 예약으로 돌린다 |
| 결과가 흩어진다 | 주제별 리포트와 날짜별 종합본을 GitHub에 커밋한다 |
다음에는 이 리포트를 글감 선정에 어떻게 쓰는지, 블로그 채널별 프로필을 어떻게 나눴는지 정리해 볼 생각이다.
부록: 실제로 받은 리포트 (패션, 2026년 10월 셋째 주)
결과물이 어떻게 생겼는지 패션 리포트 일부를 옮긴다. 이 프로필에는 내 체형과 생활 패턴이 들어가 있어서, 신체 치수·사이즈 메모·가진 물건 같은 개인 정보는 뺐다. 표는 원문에서 몇 줄만 골랐다.
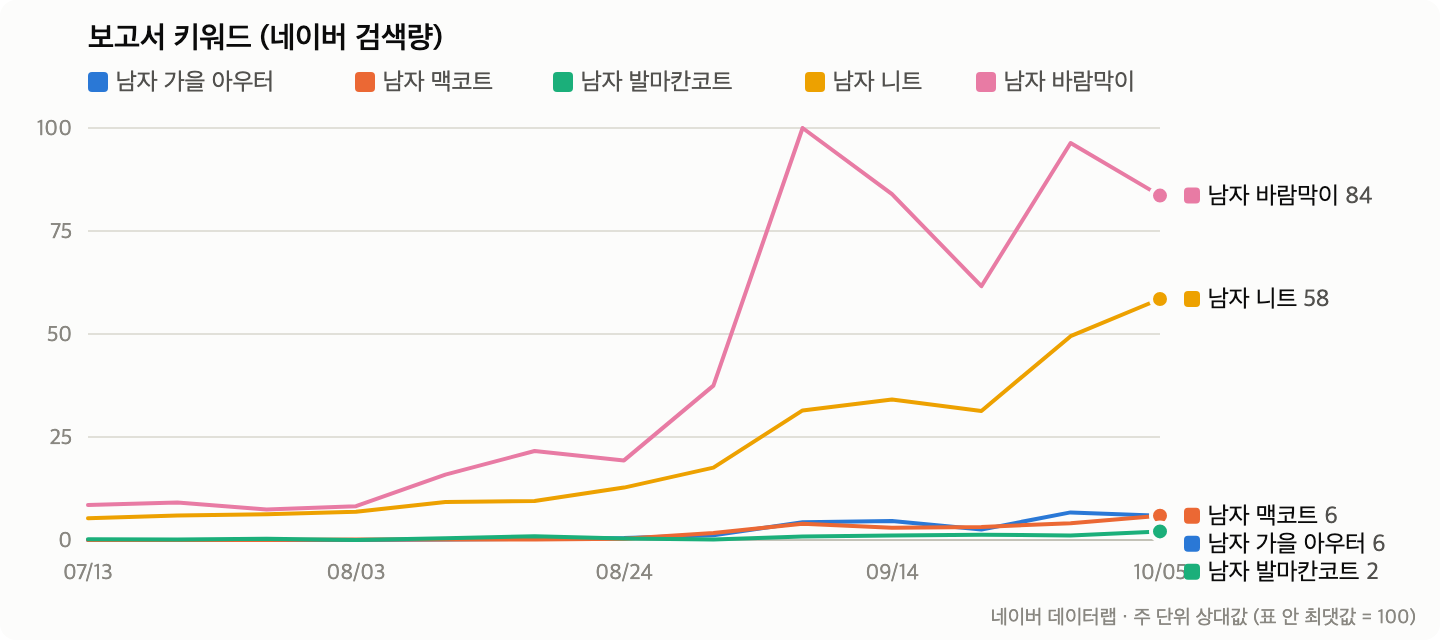
검색어 추이 차트
리포트마다 스크립트가 네이버 데이터랩 값으로 SVG 차트를 그려 붙인다. 아래는 AI가 제출한 '추이 확인 키워드' 차트다. 9월부터 바람막이·니트가 먼저 오르고, 10월 들어 코트류가 따라 오르기 시작한 게 보인다.
핵심 트렌드 (일부)
| 트렌드 | 상승 근거 | 원본 링크 | 찾은 쪽 | 데이터 |
|---|---|---|---|---|
| 가을 아우터·자켓 | 검색량 최근 4주 +216%, 스웨이드자켓 +140% | 에스콰이어 코리아 | 둘 다 | 상승 확인 (지난주 1.3배) |
| 니트 (크루넥·하프집업) | 쇼핑 클릭 +178%, 검색량 +143% | 에스콰이어 코리아 | 둘 다 | 상승 확인 (지난주 1.6배) |
| 처카부츠 | 패션잡화 쇼핑 클릭 +33% | 무신사 | Gemini | 관찰 (신규 검색어, 지난주 0.0배) |
'찾은 쪽'과 '데이터' 열이 통합 단계에서 붙는 칸이다. 한쪽 모델만 찾았고 숫자 근거가 약한 처카부츠는 아래로 내려갔다.
지금 팔리는 것 (일부)
| 아이템 | 브랜드 | 가격 | 근거 | 링크 |
|---|---|---|---|---|
| 데일리 발마칸 코트 | 무신사 스탠다드 | 129,900원 | 발마칸코트 검색 +150% | 상세 |
| 메리노 울 크루 넥 니트 | 무신사 스탠다드 | 49,900원 | 니트 쇼핑 클릭 +178% | 상세 |
| 리얼 와이드 히든 밴딩 슬랙스 | 무신사 스탠다드 | 49,900원 | 와이드 슬랙스 검색 +23% | 상세 |
리포트는 확인하지 못한 것도 그대로 적는다. 이 주에는 무신사 랭킹 페이지가 열리지 않아 "카테고리 순위는 어느 쪽도 확인하지 못했다"고 표시돼 있었다. 가격은 상품 페이지 기준이다.
인기 영상 (일부)
| 제목 | 채널 | 조회수 | 업로드일 | 링크 |
|---|---|---|---|---|
| 남자 가을 아우터, 2026년 독보적 1등은 이겁니다 (유료 프로모션 포함) | 탈패션 FASHION | 약 5.5만~6만 회 | 2026-09-27 | YouTube |
상세 링크(watch?v=)가 없거나 조회수 표기가 출처마다 엇갈린 영상은 통합 단계에서 빠지거나 "미확인"으로 남는다. 협찬·프로모션 여부도 표시한다.
코디 제안과 착용 예시
마지막으로 숫자로 확인된 품목을 내 생활(출근, 주말 출사)에 맞춰 코디 3개로 묶고, 이미지 생성 모델로 착용 예시를 만들어 붙인다. 프로필에 적은 체형·스타일 설명으로 가상 인물을 그린 것이라 실제 인물이 아니다.
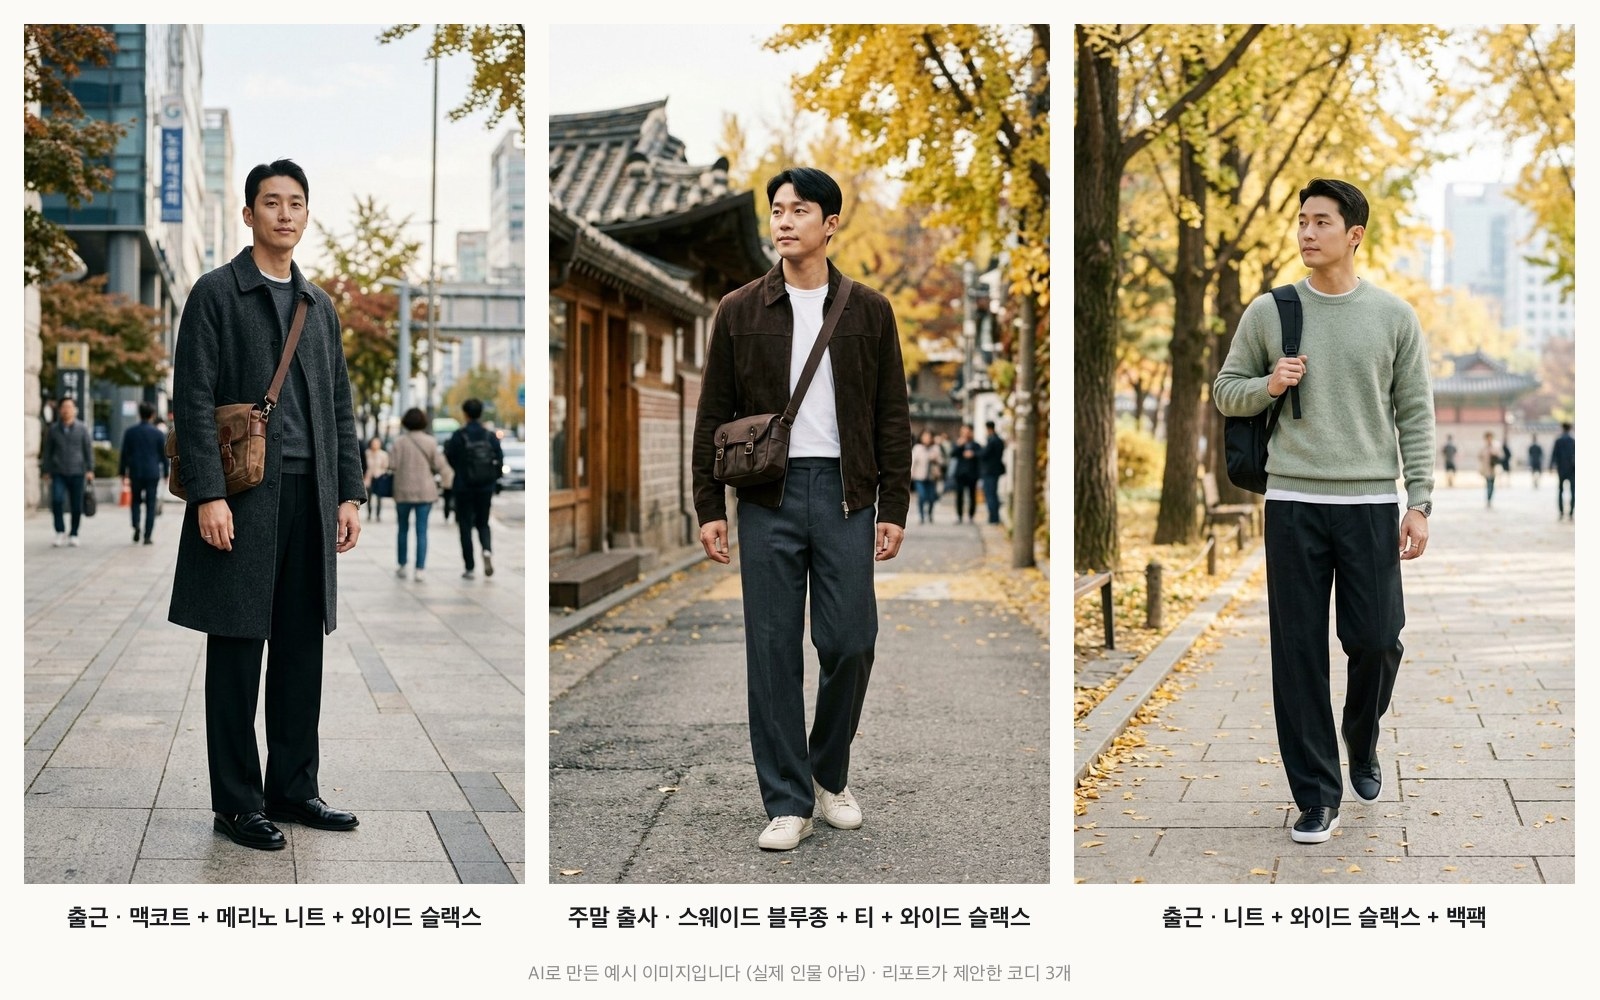
1) 출근: 맥코트 + 메리노 니트 + 와이드 슬랙스. 맥코트 검색 +167%, 니트 쇼핑 클릭 +178%가 근거다.
2) 주말 출사: 스웨이드 블루종 + 티셔츠 + 와이드 슬랙스. 가을 아우터 검색 +216%, 스웨이드자켓 +140%.
3) 출근: 니트 단품 + 와이드 슬랙스 + 백팩. 니트 +143%, 와이드 슬랙스 +23%.
코디마다 새로 살 것(상품 링크·가격)과 가진 옷으로 대체하는 방법이 같이 나온다. 실제로 이 리포트를 보고 계절에 맞는 가방을 하나 골랐다.
장비와 일상 이야기는 네이버 블로그 섭코딩에 쓰고 있다. 셀프 인테리어, 카메라 장비 사용기처럼 이 리포트에서 출발한 글도 거기에 작성예정이다. 영상으로는 유튜브 섭코딩에서 다룬다.